Die Anbindung einer Maschine ist heute meist schnell gelöst. Konnektoren sprechen OPC UA, Modbus oder Siemens S7 nativ, sodass neue Datenquellen oft innerhalb weniger Minuten verfügbar sind. Damit ist jedoch nur die Konnektivität hergestellt, nicht die Interoperabilität. Für ERP, MES oder Datenmodelle müssen Rohwerte erst kontextualisiert, vereinheitlicht, modelliert und verteilt werden. Genau dieser Schritt dauert oft Wochen oder Monate. Die selbstvernetzende Fabrik automatisiert deshalb die gesamte Kette: von der Erkennung einer Datenquelle über Kontextualisierung und Modellierung bis zur Verteilung. Dieser Artikel zeigt fünf Reifegrade, die wichtigsten technischen Engpässe und die Rolle von KI auf diesem Weg.
Was ist eine selbstvernetzende Fabrik?
Eine Fabrik ist dann selbstvernetzend, wenn ein neuer Teilnehmer ohne individuelles Integrationsprojekt am gemeinsamen Datenfluss teilnehmen kann. Dieser Teilnehmer kann eine Maschine, ein Sensor oder auch ein IT-System sein. Entscheidend ist das Kriterium ohne Projekt. Es reicht also nicht, lediglich die technische Verbindung schneller herzustellen. Automatisiert werden muss die gesamte Kette bis zu einer Information, die andere Systeme direkt verstehen und nutzen können.
Plug-and-Play setzt IT/OT-Interoperabilität auf sechs Ebenen voraus
Ein neuer Teilnehmer lässt sich nur dann per Plug-and-Play aufnehmen, wenn OT- und IT-Systeme Daten strukturiert, konsistent und ohne Medienbrüche austauschen können. Das ist die Definition von IT/OT-Interoperabilität. Entscheidend ist dabei nicht die physische Netzwerkverbindung, sondern die syntaktische und semantische Verständlichkeit der Daten. Das Data Access Model nach Matthew Parris gliedert diese Anforderung in sechs aufeinander aufbauende Ebenen (Level 0 bis 5). Plug-and-Play ist nur möglich, wenn alle Ebenen zwischen Sender und Empfänger abgestimmt sind.
| Ebene | Was sie festlegt | Beispiel |
|---|---|---|
| Level 0 – Transport | Übertragung von Bits und Bytes zwischen zwei Endpunkten | TCP/IP, UDP |
| Level 1 – Protokoll | Regeln des Nachrichtenaustauschs | OPC UA, MQTT, PROFINET |
| Level 2 – Mapping | Adressierung und Struktur der Daten im Protokoll | MQTT-Topics, OPC-UA-NodeIds |
| Level 3 – Encoding | Serialisierung der Nachricht | JSON, Protocol Buffers, OPC UA Binary |
| Level 4 – Values | Datentypen und Wertebereiche | Boolean, Integer, Float |
| Level 5 – Objects | Zusammenhang der Werte in Objekt- und Informationsmodellen | OPC UA Companion Specifications, Asset Administration Shell |
Standardprotokolle decken die Ebenen 0 und 1 ab. MQTT oder NATS standardisieren beispielsweise nur Transport und Protokoll, alles darüber bleibt offen. Ohne verbindliche Vorgaben entstehen uneinheitliche Topics (Level 2), beliebige Payload-Formate (Level 3), abweichende Datentypen und Einheiten (Level 4) und unterschiedliche Objektmodelle (Level 5).
Teams lösen das häufig mit proprietären Integrationen. Diese wirken kurzfristig effektiv, schaffen langfristig aber keine Interoperabilität. Der Aufwand für die Ebenen 2 bis 5 ist damit der Teil der Interoperabilität, den Standardprotokolle nicht abdecken und den eine selbstvernetzende Fabrik automatisiert. Die einzelnen Ebenen, ihre typischen Probleme und die Gegenmaßnahmen beschreibt der Artikel IT/OT-Interoperabilität im Unified Namespace – Grundlagen.
Drei Prozesse der selbstvernetzenden Fabrik entlang der Interoperabilitätsebenen
Damit ein neuer Teilnehmer ohne individuelles Integrationsprojekt hinzukommen kann, müssen drei Prozesse ineinandergreifen. Jeder Prozess adressiert andere Ebenen des Data Access Models:
- Erkennung (Level 0 bis 2): Das System findet ein neues Gerät im Netzwerk und bestimmt Typ und Protokoll, beispielsweise bei einer SPS (Speicherprogrammierbare Steuerung) oder einem OPC-UA-Server. Anschließend liest es die Adressen aus, die die Schnittstelle bereitstellt, etwa Register, Datenbaustein-Adressen oder NodeIds. Das Ergebnis sind erreichbare Rohdatenpunkte, aber noch keine Bedeutung.
- Zuordnung (Level 2 bis 5): Das System bildet die gefundenen Datenpunkte auf das Zielmodell des Unified Namespace ab. Es vergibt den Namen im Topic-Schema (Level 2), legt Payload-Format und Skalierung fest (Level 3) und harmonisiert Datentyp und Einheit (Level 4). Schließlich ordnet es den Datenpunkt einem Objektmodell und der Werkshierarchie zu (Level 5). Auf diesen Ebenen entsteht die Semantik.
- Betrieb (Level 0 bis 5): Das System überwacht Verbindung und Datenstrom. Es erkennt Ausfälle auf Transport- und Protokollebene (Level 0 und 1) und meldet Abweichungen von den vereinbarten Vorgaben. Beispiele sind geänderte Datentypen, unerwartete Einheiten oder Topics außerhalb der Namenskonvention (Level 2 bis 4). Auch Abweichungen vom Objektmodell gehören dazu, etwa fehlende Attribute nach einem Firmware-Update (Level 5). Eine separate Überwachung muss dafür nicht jedes Mal neu eingerichtet werden.
Die Ebenen 0 und 1 lassen sich über Standardprotokolle weitgehend automatisieren. Ab Level 2 braucht die Automatisierung ein Ziel. Die Zuordnung setzt deshalb ein verbindliches Regelwerk voraus, das pro Ebene die Optionen begrenzt. Dazu gehören eine Topic-Konvention nach ISA-95, ein einheitliches Payload-Format wie JSON, harmonisierte Datentypen und, wo vorhanden, Companion Specifications als Objektmodelle. Ohne diese Vorgaben fehlt dem System der Maßstab, an dem es eine Zuordnung ausrichten kann.
Vor allem die Zuordnung war bisher schwer zu automatisieren, weil sie Fachwissen für die Ebenen 2 bis 5 voraussetzt. Genau hier verändern Sprachmodelle die Ausgangslage. Sie können Gerätebeschreibungen, Tag-Listen und technische Dokumentationen auswerten und daraus Vorschläge für die semantische Zuordnung ableiten. Ein Fachexperte validiert und gibt die Vorschläge frei.
Fünf Reifegrade auf dem Weg zur selbstvernetzenden Fabrik
Der Weg zur selbstvernetzenden Fabrik verläuft in mehreren Stufen. Das folgende Modell ist ein Ordnungsrahmen. Es zeigt für jede Stufe, wie viel Aufwand bei der Integration einer neuen Maschine entsteht und welche Grenze den nächsten Entwicklungsschritt notwendig macht.
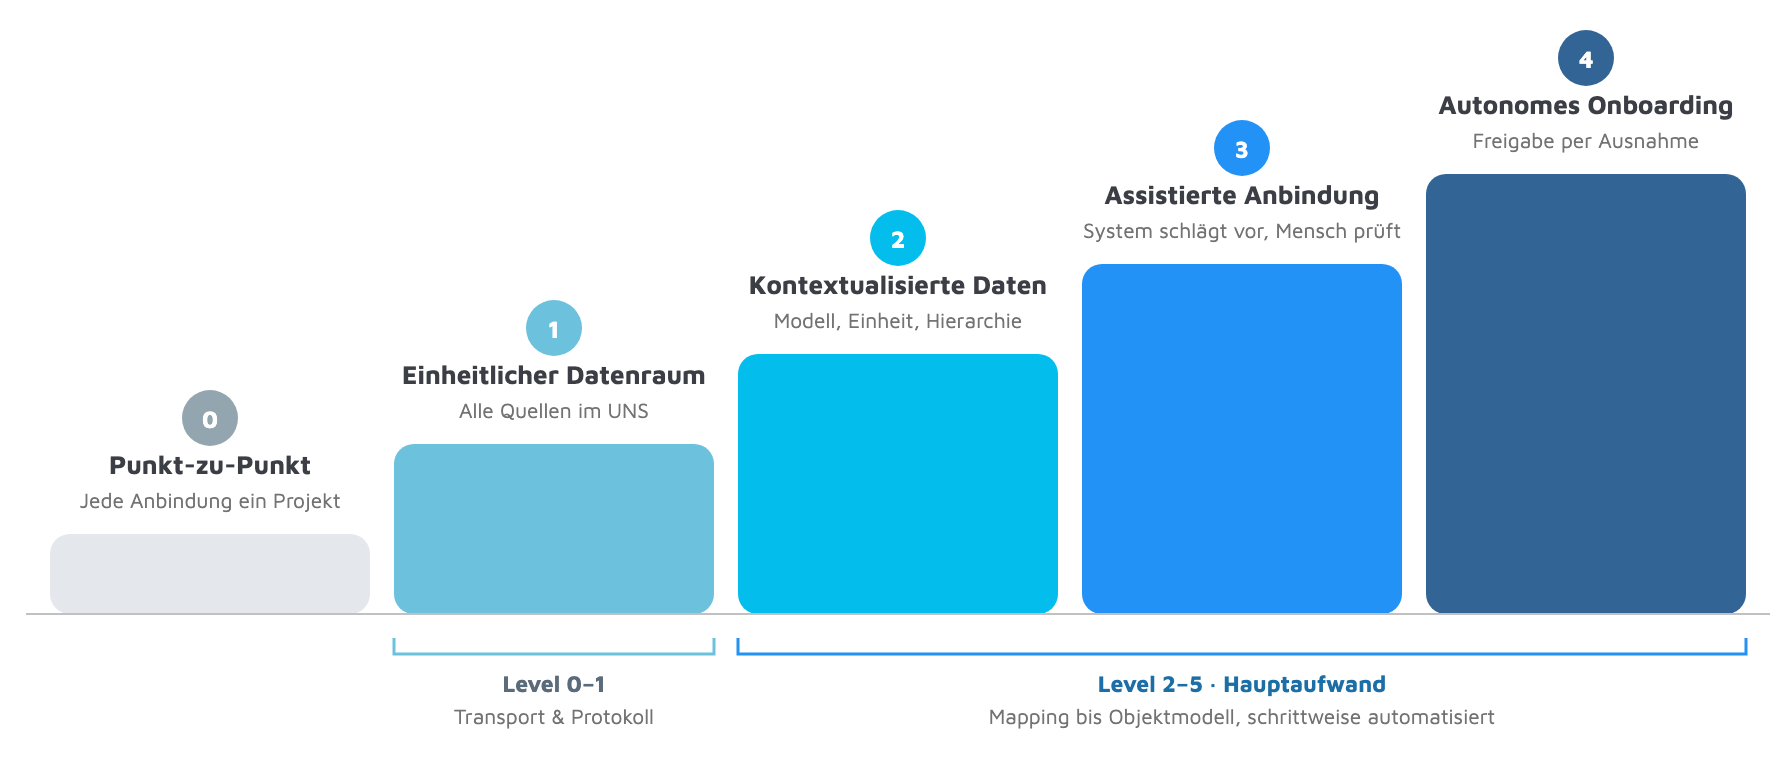
Die Stufen lassen sich den Ebenen der Interoperabilität zuordnen. Stufe 1 vereinheitlicht Transport und Protokoll (Level 0 und 1). Ab Stufe 2 geht es um Mapping, Encoding, Datentypen und Objektmodelle (Level 2 bis 5). Hier liegt der Hauptaufwand, den die Stufen 3 und 4 schrittweise automatisieren. Weil die Stufen aufeinander aufbauen, lassen sie sich nur begrenzt überspringen.
Stufe 0 bis 2: vom Einzelprojekt zum Kontext
Die ersten drei Stufen betreffen vor allem die Struktur und Verständlichkeit der Daten. Der Mensch übernimmt hier noch den größten Teil der Arbeit.
- Stufe 0 – Punkt-zu-Punkt: Jede Anbindung ist ein eigenes Projekt, und Systeme kommunizieren bilateral miteinander. Keine Interoperabilitätsebene ist übergreifend abgestimmt. Wissen steckt häufig bei einzelnen Personen, in Tabellen oder in projektspezifischer Dokumentation. Die Grenze dieser Stufe ist die Skalierbarkeit: Mit jedem zusätzlichen System steigt der Integrationsaufwand überproportional.
- Stufe 1 – Einheitlicher Datenraum: Alle Quellen veröffentlichen ihre Daten in einer gemeinsamen Infrastruktur, beispielsweise in einem Unified Namespace (UNS). Damit sind Transport und Protokoll vereinheitlicht (Level 0 und 1). Die Bedeutung der Daten bleibt jedoch offen. Wer einen Datenpunkt verstehen will, muss weiterhin Topic-Struktur und Datenschema kennen.
- Stufe 2 – Kontextualisierte Daten: Ein konsistentes Datenmodell und eine Topic-Hierarchie, beispielsweise entlang von ISA-95, ergänzen Bedeutung, Einheit und Zugehörigkeit (Level 2 bis 5). Aus einem Rohwert wird dadurch eine fachlich verständliche Information. Die Grenze dieser Stufe: Das Modell entsteht für jede Maschine weiterhin manuell. Hier liegt heute häufig der größte Projektaufwand.
Stufe 3 und 4: von der Assistenz zur Autonomie
Ab Stufe 3 verändert sich die Arbeitsteilung. Das System übernimmt zunehmend die Interpretation, während der Mensch kontrolliert und freigibt.
- Stufe 3 – Assistierte Anbindung: Ein Mensch stößt die Integration einer bestimmten Maschine an. Danach analysiert das System die Rohausgabe der Anlage und schlägt Namen, Einheiten und eine Einordnung in das Datenmodell vor. Der Mensch prüft diese Vorschläge und gibt sie frei. Automatisiert ist die Interpretation, nicht der Anlass. Genau darin liegt die Grenze dieser Stufe.
- Stufe 4 – Autonomes Onboarding: Das System erkennt selbst, dass ein Teilnehmer hinzugekommen ist oder sich verändert hat. Anschließend durchläuft es Erkennung, Zuordnung und Betrieb bis zur Publikation der Daten. Eindeutige Fälle laufen innerhalb definierter Regeln automatisch durch, unklare Fälle werden eskaliert. Der Mensch greift nur bei Ausnahmen ein. Onboarding wird damit von einem Projekt zu einer dauerhaften Funktion. Die Grenze dieser Stufe sind klare Freigaberegeln und Rollen, denn das System schreibt Konfigurationen selbstständig.
Der Übergang von Stufe 2 zu Stufe 3 ist in der Praxis besonders anspruchsvoll. Welche Infrastruktur für die Umsetzung nötig ist und warum gerade dieser Schritt hakt, zeigen die nächsten Abschnitte.
Notwendige Infrastruktur
Die Reifegrade beschreiben, wie weit die Integration neuer Teilnehmer automatisiert ist. Ob ein Werk eine Stufe erreicht, hängt jedoch von der vorhandenen Infrastruktur ab. Für die Umsetzung stellt sich deshalb die Frage: Welche technische Infrastruktur muss dafür vorhanden sein? Eine selbstvernetzende Fabrik braucht vier aufeinander aufbauende Bausteine. Fehlt ein Baustein, stößt jede weitere Automatisierung schnell an Grenzen.
Transport, Semantik, API und Freigabe
- Transportschicht: Ein gemeinsamer Datenfluss ersetzt bilaterale Verbindungen zwischen einzelnen Systemen. Der Unified Namespace stellt dafür eine gemeinsame, hierarchisch organisierte Datenbasis bereit. Die Transportschicht entspricht Stufe 1 des Reifegradmodels und den Ebenen Level 0 und 1.
- Semantikschicht: Transport allein reicht nicht. Interoperabilität entsteht erst, wenn Systeme dieselben Informationen gleich interpretieren. Dazu gehören Adressierung, Encoding, Einheiten und semantische Modelle (Level 2 bis 5).
- API-Schicht: IT-Systeme und Agenten benötigen einen einheitlichen Zugriff auf den Datenraum.
- Agenten- und Freigabeschicht: Diese Ebene legt fest, welche Aktionen ein Agent selbstständig ausführen darf, wo ein Mensch freigibt und welche Entscheidungen protokolliert werden müssen. Sie ermöglicht die Stufen 3 und 4 des Reifegradmodels.
Warum die Reihenfolge der Bausteine entscheidend ist
Die vier Bausteine bilden einen Stack, in dem jede Schicht auf der darunterliegenden aufbaut. Ohne Transportschicht fehlt die gemeinsame Grundlage. Ohne Semantik liefert eine API lediglich schwer verständliche Rohwerte. Und ohne verlässlichen Zugriff kann auch eine Agentenschicht nicht sicher arbeiten. Wer Agenten einführt, bevor ein konsistentes Datenmodell existiert, automatisiert im schlimmsten Fall nur die Entstehung neuer Inkonsistenzen.
Für die selbstvernetzende Fabrik gilt daher: zuerst Zielmodell und Regelwerk festlegen, dann die Zuordnung automatisieren. Die Semantik wird dabei nicht übersprungen. Sie wird einmal definiert und lässt sich danach auf weitere Maschinen übertragen.
Beispielimplementierung
Die vier Bausteine beschreiben, was vorhanden sein muss. Wie sich die Zuordnung auf dieser Basis automatisieren lässt, zeigt der OneClick UNS von i-flow. Die semantische Arbeit blockierte bisher häufig den Übergang von Stufe 2 zu Stufe 3. Hier setzt KI an: Sie leitet Zuordnungen ab, die sich an einem festgelegten Zielmodell ausrichten. Der Ansatz gliedert den Prozess in drei Schritte:
- Auto Discovery (entspricht der Erkennung): i-flow identifiziert SPSen, OPC-UA-Server und weitere Datenquellen im Netzwerk und verbindet sie automatisiert.
- Auto Modeling (entspricht der Zuordnung): Für einen erkannten Maschinentyp schlägt das System ein passendes Standardschema vor. Dieses Schema dient als Zielmodell, an dem sich die Zuordnung ausrichtet. Dadurch wird ein Teil der Modellierungsarbeit automatisiert, die sonst manuell erfolgen müsste.
- Auto Publishing (nach der Freigabe): Nach der Freigabe veröffentlicht das System die strukturierten Daten automatisch im Unified Namespace.
Human-in-the-Loop: der Mensch als Prüfinstanz
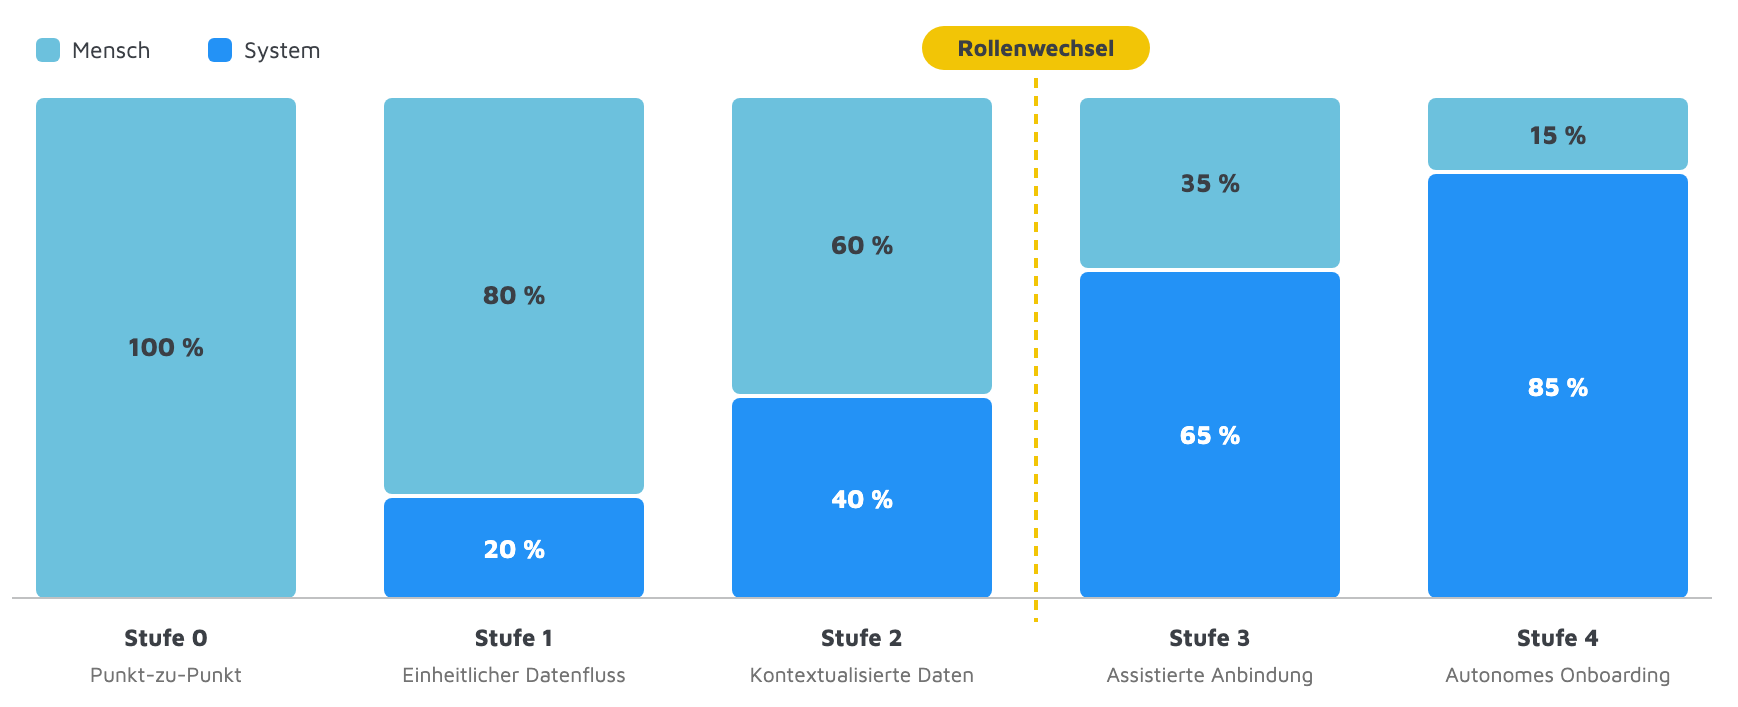
Nach dem Prinzip Human-in-the-Loop (HITL) geht keine Konfiguration ohne Freigabe in Betrieb. Das entspricht der Agenten- und Freigabeschicht der Infrastruktur. Damit verändert sich die Rolle des Menschen. Er erstellt die Zuordnung nicht mehr vollständig selbst, sondern prüft und bestätigt die Vorschläge des Systems. Dieser Rollenwechsel kennzeichnet den Übergang von manueller Integration zu assistiertem und schließlich autonomem Onboarding. Die folgende Grafik veranschaulicht diese Verschiebung.
Aktuelle Hürden auf dem Weg zur selbstvernetzenden Fabrik
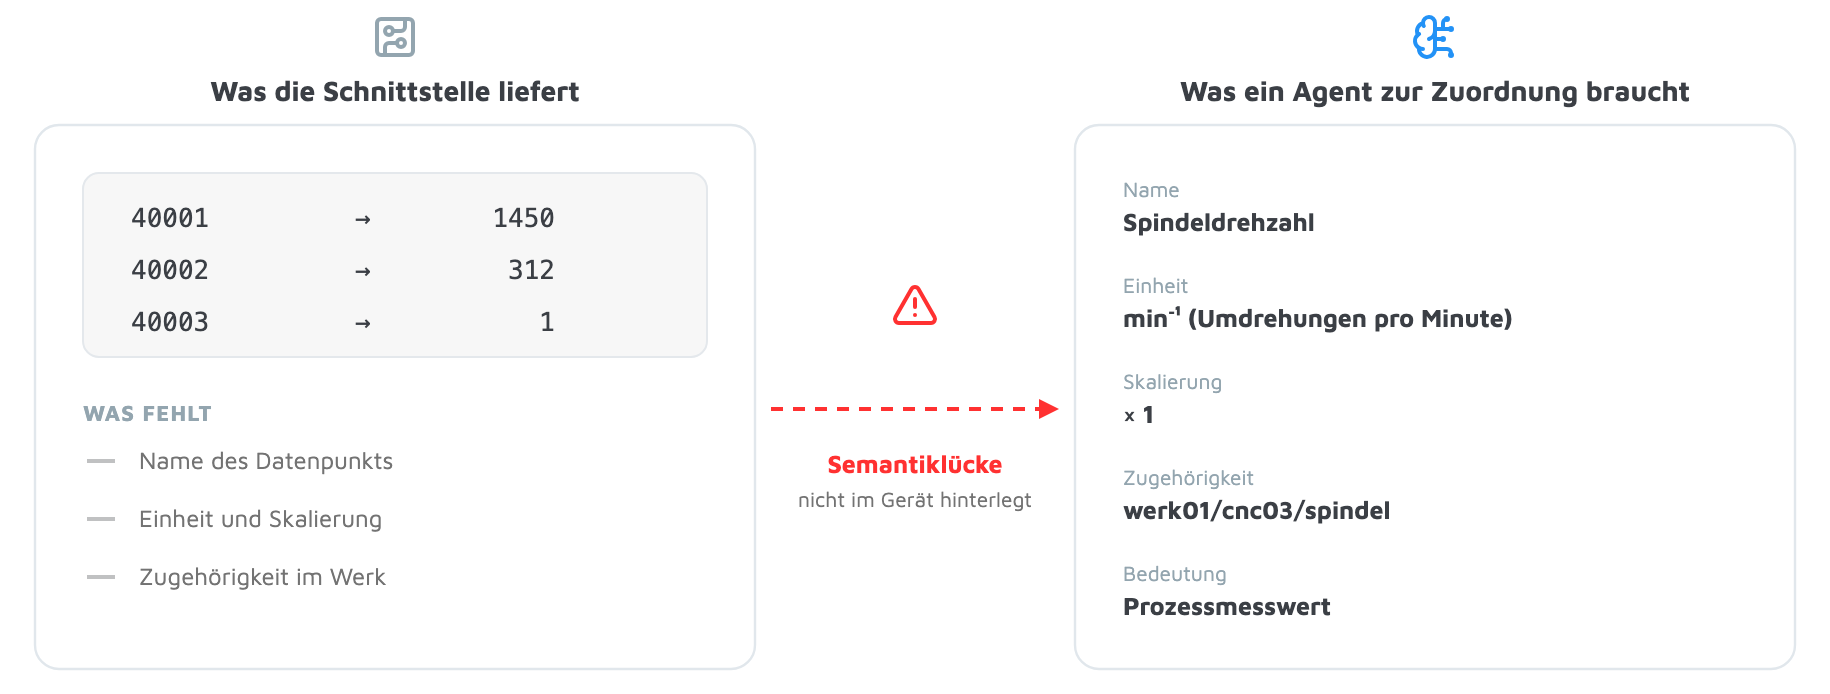
Auch mit der passenden Infrastruktur und KI-Unterstützung bleibt ein Engpass bestehen. Eine automatische Erkennung kann nur Informationen finden, die eine Schnittstelle tatsächlich bereitstellt. Genau hier liegt eines der größten Probleme im Brownfield. Viele verbreitete OT-Protokolle übertragen zwar Werte, enthalten aber kaum Informationen über deren fachliche Bedeutung. Zwei Beispiele aus der Praxis:
- Modbus: Ein Register liefert beispielsweise die Adresse
40001und den Wert1450. Daraus geht jedoch nicht hervor, wie der Wert heißt, welche Einheit er besitzt oder welche Skalierung gilt. Die Information „Spindeldrehzahl in Umdrehungen pro Minute“ steckt nicht im Register selbst. - Siemens S7 nativ: Bei absoluter Adressierung erfolgt der Zugriff beispielsweise über Datenbaustein-Adressen wie
DB10.DBW4. Die Struktur folgt häufig einer projektspezifischen Konvention und erklärt ihre fachliche Bedeutung nicht selbst.
Konsequenz: Stufe 2 lässt sich nicht überspringen
Aus den Beispielen folgt eine zentrale Erkenntnis: Viele Maschinen stellen technische Endpunkte bereit, aber keine ausreichende Semantik. Der technische Transport kann deshalb schon nach kurzer Zeit funktionieren. Die fachliche Einordnung braucht dagegen deutlich länger. Die fehlende Semantik muss mindestens einmal ergänzt werden. Mögliche Quellen dafür sind technische Dokumentationen, vorhandene Standards oder das Wissen des Maschinenintegrators. Erst danach kann ein System diese Zuordnung automatisieren und auf weitere Maschinen desselben Typs übertragen.
Fazit: Die selbstvernetzende Fabrik beginnt bei der Interoperabilität
Die selbstvernetzende Fabrik ist ein Reifegrad der industriellen Datenintegration. Ein neuer Teilnehmer lässt sich nur dann ohne Projekt aufnehmen, wenn die Interoperabilität auf allen sechs Ebenen des Data Access Models abgestimmt ist.
- Der Aufwand liegt in der Semantik: Transport und Protokoll (Level 0 und 1) decken Standardprotokolle ab. Den Hauptaufwand verursachen Mapping, Encoding, Datentypen und Objektmodelle (Level 2 bis 5), denn viele OT-Schnittstellen liefern Werte ohne Bedeutung.
- Erst das Zielmodell, dann die Automatisierung: Vier aufeinander aufbauende Bausteine bilden die Infrastruktur. Wer Zielmodell und Regelwerk einmal festlegt, kann die Zuordnung danach automatisieren und auf weitere Maschinen übertragen.
- KI interpretiert, der Mensch gibt frei: Ab Stufe 3 erstellt das System die Vorschläge. Der Mensch prüft, gibt frei und behandelt Ausnahmen.
Sinnvoll ist deshalb ein Vorgehen Stufe für Stufe. Wer die Semantik einmal sauber definiert, macht jede weitere Maschine zur Wiederholung statt zum Projekt.