Künstliche Intelligenz in der Fertigung wird meist als Cloud-Thema gedacht: Daten sammeln, in ein Rechenzentrum senden, dort ein Modell rechnen lassen. Für viele Anwendungsfälle scheitert dieser Weg jedoch an der Realität des Factory Floors – an Latenz, Bandbreite und der Frage, wer die Daten überhaupt sehen darf. Edge KI dreht diesen Ansatz um und verlagert die eigentliche Entscheidung dorthin, wo sie gebraucht wird: direkt an die Maschine. Statt Rohdaten in die Cloud zu streamen, läuft die KI-Inferenz lokal auf Hardware nah am Prozess. Dieser Artikel erklärt, was Edge KI ist, wann sie der Cloud überlegen ist, wie die Architektur im Unified Namespace (UNS) aussieht und wie Sie den Ansatz an konkreten Fertigungsbeispielen schrittweise umsetzen.
Was ist Edge KI?
Edge KI (englisch: Edge AI) bezeichnet die Ausführung von KI-Modellen direkt auf lokaler Hardware nah an der Datenquelle – auf einem Industrie-PC an der Linie, einem Gateway im Schaltschrank oder einem Sensor mit eigenem Prozessor. Der Begriff verbindet zwei Felder: Edge Computing, also die dezentrale Datenverarbeitung nahe der Quelle statt im zentralen Rechenzentrum, und maschinelles Lernen als Teil der Industrial-AI-Bewegung.
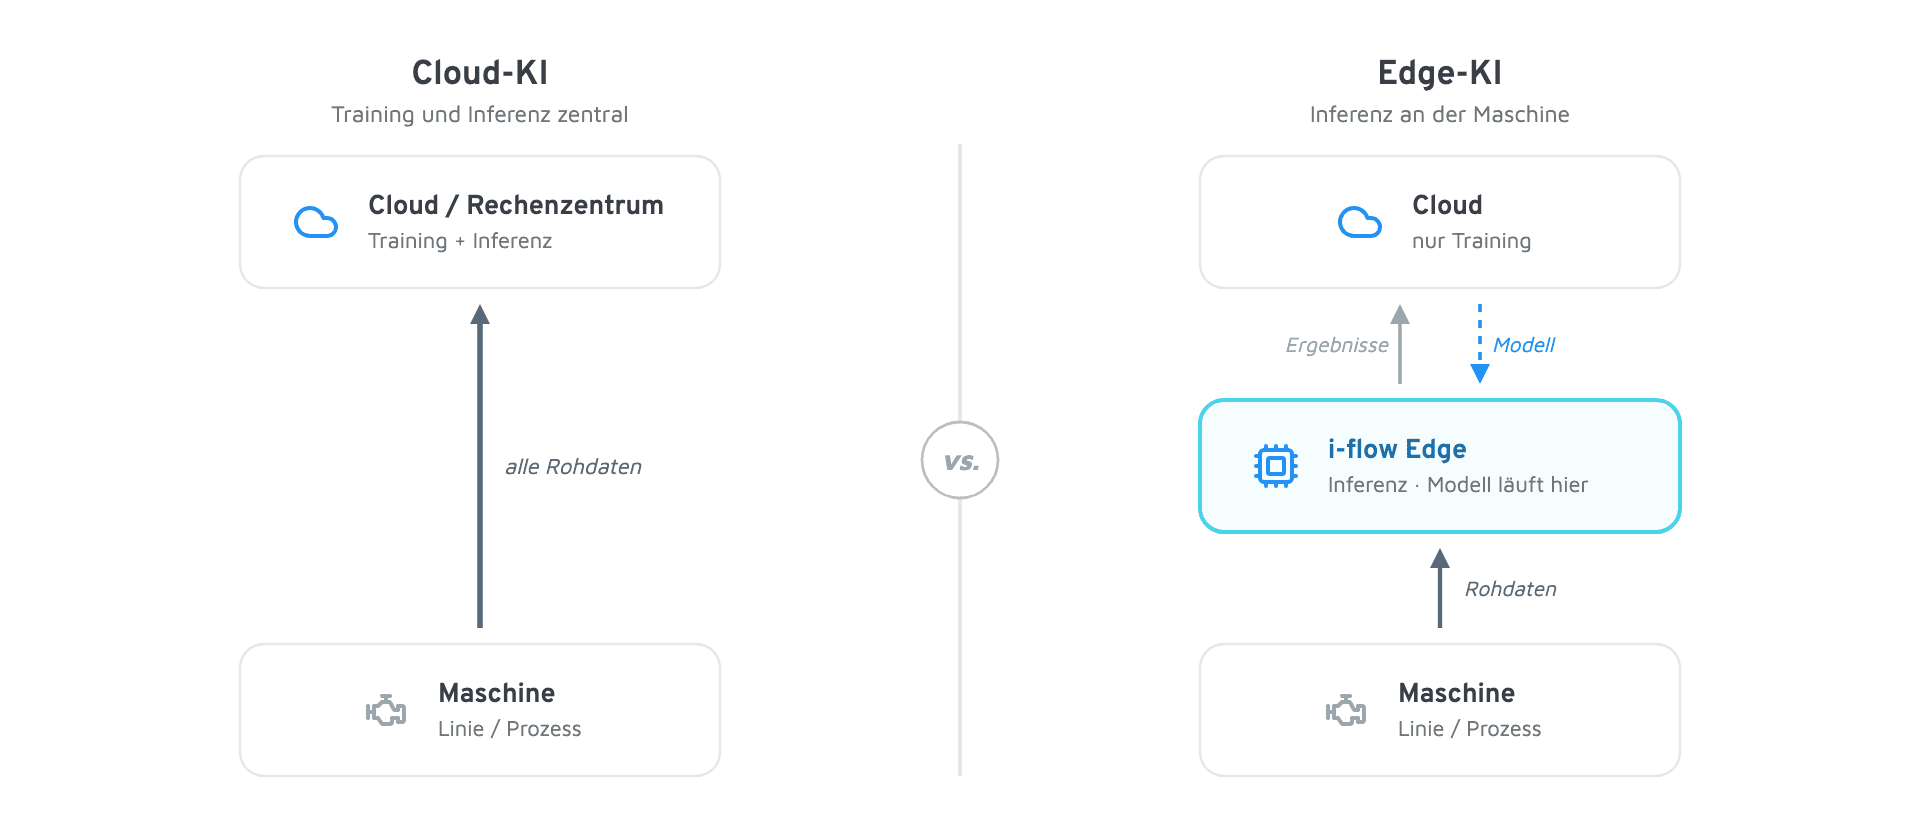
Entscheidend für das Verständnis ist die Trennung zweier Phasen im Lebenszyklus eines Modells:
- Training: Das rechenintensive Erstellen eines Modells aus großen Mengen historischer Daten. Training braucht viel Rechenleistung und findet meist zentral statt – in der Cloud oder auf einem leistungsstarken Server.
- Inferenz: Das Anwenden des fertig trainierten Modells auf neue, aktuelle Daten, um eine Vorhersage oder Klassifikation zu liefern. Inferenz ist deutlich ressourcenärmer und latenzkritisch.
Edge KI betrifft in erster Linie die Inferenz. Das Modell wird zentral trainiert, dann aber an die Maschine ausgeliefert und dort betrieben. Genau diese Arbeitsteilung – zentrales Training, dezentrale Inferenz – ist der Kern des Ansatzes und unterscheidet ihn von der reinen Cloud-KI, bei der beide Phasen im Rechenzentrum ablaufen.
Warum KI auf der Edge? Edge vs. Cloud
Die Cloud bleibt für viele KI-Aufgaben der richtige Ort – vor allem für das Training und für Analysen über viele Standorte hinweg. Für die Inferenz am Prozess sprechen jedoch vier handfeste Gründe für die Edge.
Die vier Treiber für Edge KI
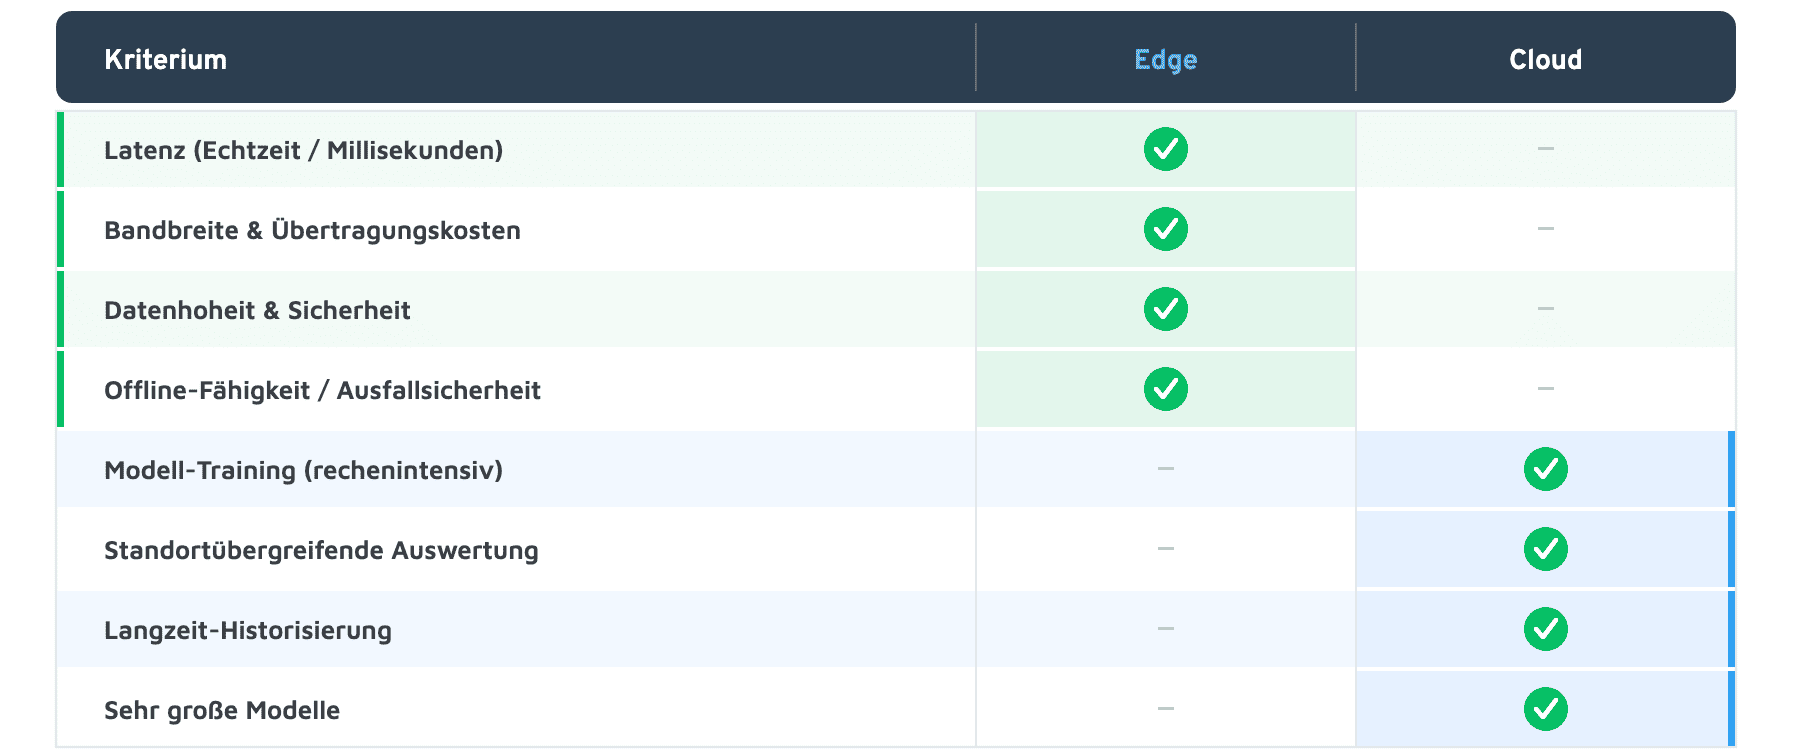
- Latenz: Eine Entscheidung, die den Prozess steuert, muss in Millisekunden fallen. Der Umweg über ein Rechenzentrum kostet zu viel Zeit – bei einer Sortierweiche oder einem Auswurf am Fließband ist er schlicht nicht praktikabel.
- Bandbreite und Kosten: Hochfrequente Rohdaten wie Bilder oder Schwingungssignale in die Cloud zu streamen, ist teuer und oft technisch gar nicht möglich. Edge KI wertet lokal aus und überträgt nur das Ergebnis.
- Datenhoheit und Sicherheit: Sensible Produktionsdaten bleiben im Werk. Das reduziert die Angriffsfläche und erleichtert die Einhaltung interner wie regulatorischer Vorgaben.
- Offline-Fähigkeit: Die Inferenz läuft weiter, auch wenn die Internetverbindung ausfällt. Für Anlagen, die nicht stillstehen dürfen, ist diese Unabhängigkeit entscheidend.
Die Grenzen der Edge
Edge KI ist jedoch kein Ersatz für die Cloud, sondern eine Ergänzung. Die dezentrale Ausführung bringt reale Einschränkungen mit sich, die man ehrlich abwägen muss:
- Begrenzte Rechenleistung: Edge-Hardware ist ressourcenbeschränkt. Sehr große Modelle laufen dort nicht ohne Weiteres und müssen zuerst verkleinert werden.
- Verteiltes Management: Ein Modell auf hundert Edge-Geräten zu aktualisieren, ist aufwändiger als ein Update in der Cloud – ohne ein zentrales Management wird das schnell unübersichtlich.
- Kein Training vor Ort: Das eigentliche Lernen bleibt zentral. Die Edge führt aus, sie trainiert nicht.
Die Konsequenz: Latenzkritische, bandbreitenintensive oder datenschutzsensible Inferenz gehört auf die Edge. Training, standortübergreifende Auswertung und langfristige Historisierung bleiben zentral. Die folgende Grafik ordnet die typischen Kriterien den beiden Orten zu.
Architektur: Edge KI im Unified Namespace
Damit Edge KI im Betrieb funktioniert, braucht es eine klare Arbeitsteilung zwischen zentraler und dezentraler Ebene – und eine verlässliche Datenschicht, die beide verbindet. Genau hier setzt der Unified Namespace (UNS) an: eine zentrale, hierarchisch organisierte Datenschicht, in der alle Systeme Daten über einen gemeinsamen Message Broker wie MQTT oder NATS als Single Source of Truth (SSOT) veröffentlichen und konsumieren.
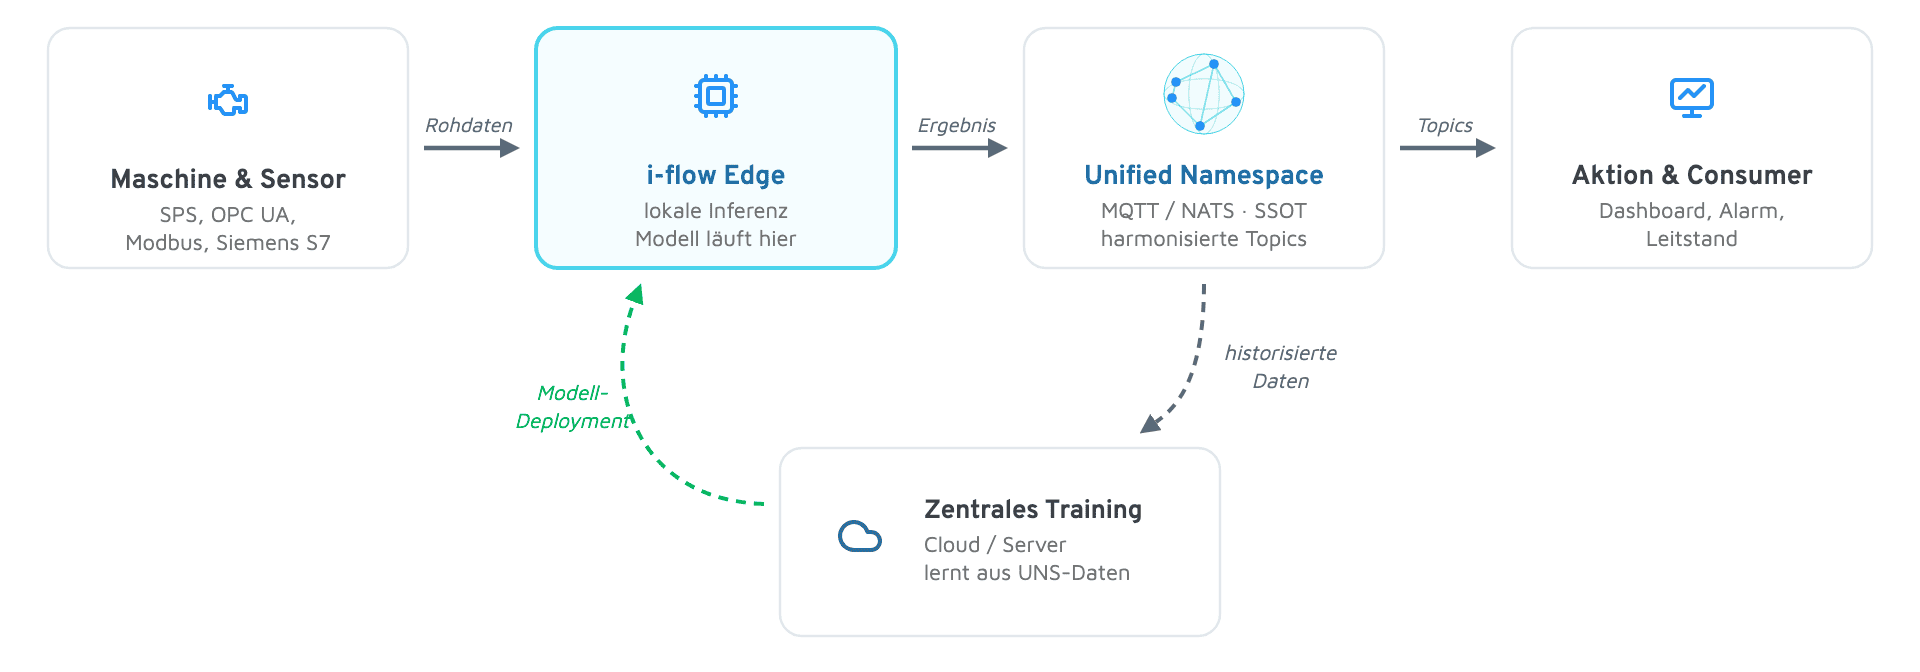
Der typische Kreislauf einer Edge-KI-Lösung durchläuft vier Stationen:
- Datenerfassung an der Quelle: Der i-flow Edge verbindet sich mit SPS, Sensoren und SCADA-Systemen über native Protokolle wie
OPC UA,ModbusoderSiemens S7und normalisiert die Rohdaten lokal. - Lokale Inferenz: Das trainierte Modell läuft direkt auf der Edge und wertet die Daten in Echtzeit aus – ohne Umweg über die Cloud.
- Ergebnisse in den UNS: Die Vorhersage – etwa ein Qualitätsurteil oder ein Anomalie-Score – wird strukturiert in den UNS publiziert und steht damit allen Systemen zur Verfügung.
- Zentrales Training als Regelkreis: Historisierte Daten aus dem UNS fließen zentral in das Training zurück. Verbesserte Modelle werden anschließend erneut auf die Edges ausgerollt.
So entsteht ein geschlossener Kreislauf: Die Edge liefert Inferenz in Echtzeit, das Zentrum liefert stetig bessere Modelle. Der UNS ist dabei sowohl die Datenquelle für die Inferenz als auch das Ziel ihrer Ergebnisse.
Beispiele aus der Fertigung
Der Ansatz ist kein abstraktes Konzept – er löst konkrete Probleme auf dem Factory Floor. Drei Anwendungsfälle zeigen, warum die Inferenz gerade dort an die Maschine gehört.
Optische Qualitätsinspektion
Eine Kamera prüft Bauteile direkt an der Linie auf Kratzer, Maßabweichungen oder Montagefehler. Ein Bildklassifikationsmodell entscheidet in Millisekunden, ob ein Teil gut oder Ausschuss ist. Hier zeigt sich der Bandbreiten-Vorteil deutlich: Es wäre unwirtschaftlich, jeden Bilderstrom in die Cloud zu senden. Das Modell läuft auf der Edge, und nur das Prüfergebnis – nicht das Bild – wandert in den UNS.
Anomalie- und Zustandserkennung an Antrieben
Vibrations- und Temperatursensoren an einem Antriebsmotor liefern hochfrequente Signale. Ein Modell auf der Edge erkennt abweichende Muster, die auf einen beginnenden Lagerschaden hindeuten – die klassische Grundlage für Predictive Maintenance. Da die Auswertung lokal geschieht, bleibt sie auch bei einer Störung der Cloud-Anbindung aktiv.
Echtzeit-Prozessoptimierung
Bei einem kontinuierlichen Prozess – etwa einem Ofen oder einer Extrusionslinie – unterstützt ein Modell die Regelung, indem es aus aktuellen Prozessgrößen die optimale Sollwert-Anpassung vorschlägt. Weil der Regeleingriff quasi sofort erfolgen muss, ist die geringe Latenz der Edge hier die entscheidende Voraussetzung.
Edge KI implementieren
Der Einstieg gelingt am besten schrittweise – an einem klar abgegrenzten Anwendungsfall statt als flächendeckendes Großprojekt. Die folgenden fünf Schritte bilden einen bewährten Weg, um Edge KI produktionsreif aufzubauen.
- Anwendungsfall und Latenzanforderung definieren: Klären Sie zuerst, was das Modell entscheiden soll und wie schnell. Genau diese Latenzanforderung entscheidet, ob die Inferenz auf die Edge gehört oder in der Cloud bleiben kann.
- Daten anbinden und im UNS harmonisieren: Verbinden Sie die relevanten Signale über native Protokolle und vereinheitlichen Sie Einheiten, Zeitstempel und Namenskonventionen in einer konsistenten Topic-Struktur nach ISA-95, zum Beispiel
werk01/assembly/line01/motor01/vibration. - Modell zentral trainieren: Trainieren Sie das Modell auf historisierten UNS-Daten – in der Cloud oder auf einem Server mit ausreichend Rechenleistung. Beginnen Sie mit dem einfachsten tragfähigen Modell und steigern Sie die Komplexität erst bei Bedarf.
- Modell für die Edge optimieren: Verkleinern Sie das Modell, damit es auf ressourcenbeschränkter Hardware läuft. Techniken wie Quantisierung – das Reduzieren der Zahlengenauigkeit im Modell – senken Speicherbedarf und Rechenlast, ohne die Treffsicherheit wesentlich zu beeinträchtigen.
- Deployen, publizieren und überwachen: Rollen Sie das Modell auf den i-flow Edge aus, betreiben Sie die Inferenz lokal und publizieren Sie die Ergebnisse in den UNS. Überwachen Sie dabei den Model Drift – verändern sich Prozesse, Materialien oder Maschinen, verliert ein Modell an Treffsicherheit und muss nachtrainiert werden.
Wichtig ist der iterative Charakter: Ein erstes Modell wird selten perfekt sein. Sammeln Sie Betriebserfahrung, verfeinern Sie die Modelle im zentralen Training und weiten Sie den Ansatz erst dann auf weitere Maschinen und Anwendungsfälle aus.
i-flow als Fundament für Edge KI
Da Edge KI zuerst eine Frage der richtigen Verortung von Daten und Inferenz ist, liegt der Hebel in einer Plattform, die zentrale Steuerung und dezentrale Ausführung sauber trennt. Die i-flow-Plattform folgt genau diesem Prinzip: zentrale Konfiguration im i-flow Hub, dezentrale Ausführung über i-flow Edges nah an der Maschine.
Der i-flow Edge ist der natürliche Ort für die lokale Inferenz. Er verbindet sich direkt mit SPS, Sensoren und SCADA-Systemen, normalisiert die Rohdaten mit minimaler Latenz und stellt sie einem lokal laufenden Modell bereit. Der i-flow Hub verwaltet Datenmodelle, Verbindungen und Konfigurationen zentral und rollt Änderungen konsistent auf alle Edges aus – die Antwort auf die Management-Herausforderung verteilter Edge-KI. Der i-flow Broker stellt den zentralen Message Broker bereit und sorgt dafür, dass sowohl die Eingangsdaten als auch die Inferenz-Ergebnisse zuverlässig im UNS ankommen.
Für Edge KI heißt das konkret: Die harmonisierten Daten stehen lokal wie zentral bereit, das Modell läuft dort, wo die Entscheidung fällt, und die Ergebnisse sind über den UNS für jedes weitere System nutzbar – ohne proprietäre Punkt-zu-Punkt-Verbindungen.
Fazit
Edge KI ist keine Konkurrenz zur Cloud, sondern die richtige Verortung der KI-Inferenz. Sie bringt die Entscheidung dorthin, wo sie gebraucht wird – an die Maschine, in Echtzeit, unabhängig von der Netzanbindung. Das Training bleibt zentral, die Ausführung wandert an die Edge. Entscheidend ist dabei, wie bei jeder Industrial-AI-Initiative, das Datenfundament: Ohne kontinuierliche, harmonisierte Daten bleibt selbst das beste Modell wirkungslos. Drei zentrale Erkenntnisse:
- Inferenz gehört dorthin, wo die Entscheidung fällt: Latenz, Bandbreite, Datenhoheit und Offline-Fähigkeit sprechen für die lokale Ausführung an der Maschine.
- Training bleibt zentral: Edge KI führt aus, sie lernt nicht. Der Regelkreis aus zentralem Training und dezentraler Inferenz hält die Modelle aktuell.
- Das Datenfundament entscheidet: Ein Unified Namespace liefert die harmonisierten Daten – als Quelle für die Inferenz und als Ziel ihrer Ergebnisse.
Wer heute das Datenfundament legt, schafft die Basis nicht nur für Edge KI, sondern für alle weiteren Industrial-AI-Anwendungen im gesamten Werk.