Automatisierung prägt die Produktion seit Jahrzehnten – doch sie folgt fast immer festen Regeln. Eine SPS (Speicherprogrammierbare Steuerung) schaltet, wenn ein Grenzwert überschritten wird; SCADA-Systeme visualisieren und quittieren nach klar definierter Logik. Dieses deterministische Fundament ist zuverlässig, stößt aber an Grenzen, sobald Aufgaben zu variabel für starre Regeln werden. Genau hier setzt KI Automation an: Sie ergänzt die klassische Steuerung um Wahrnehmung, Vorhersage und lernende Entscheidungen. Statt jede Ausnahme vorab zu programmieren, erkennen KI-Modelle Muster in Echtzeitdaten und handeln darauf. Dieser Artikel erklärt, was KI Automation ausmacht, wie sie sich von der klassischen Automatisierung unterscheidet und wie Sie damit konkrete Aufgaben auf dem Shopfloor automatisieren.
Was ist KI Automation?
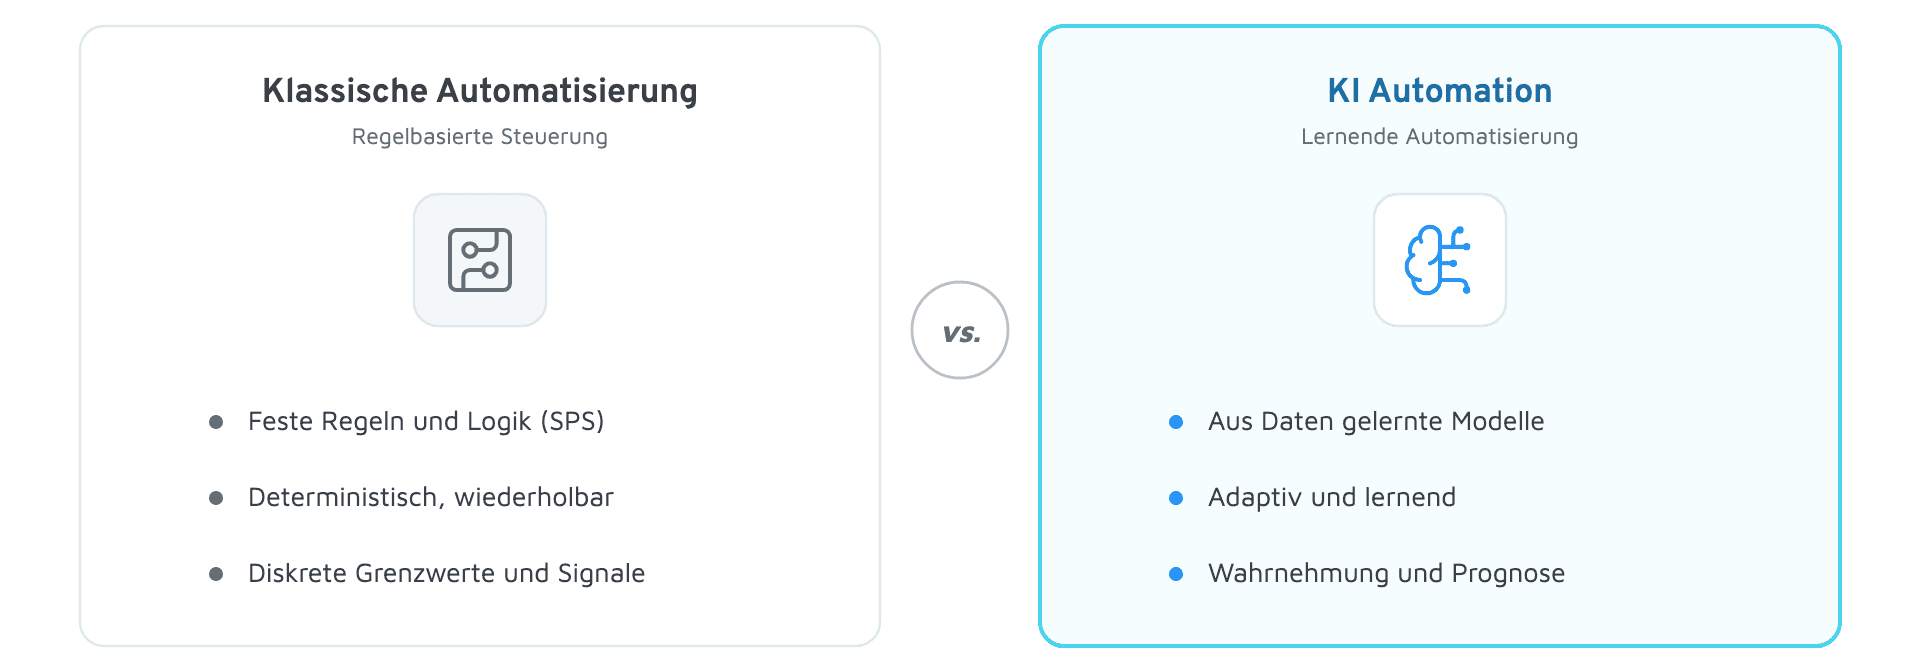
KI Automation bezeichnet die Verbindung von künstlicher Intelligenz mit klassischer Automatisierung, um Aufgaben zu übernehmen, die für feste Regeln zu variabel sind. Die klassische Automatisierung führt eine vorab definierte Logik aus. KI Automation ergänzt diese Logik um drei Fähigkeiten, die sich aus Daten ableiten lassen:
- Wahrnehmung: Modelle interpretieren Bilder, Geräusche oder komplexe Signalmuster – etwa ein Kamerabild einer Schweißnaht, das keine einfache Grenzwertregel beschreiben kann.
- Vorhersage: Aus historischen und aktuellen Verläufen prognostizieren Modelle künftige Zustände, beispielsweise einen drohenden Lagerschaden oder den Ausschussanteil einer Charge.
- Entscheidung: Auf Basis dieser Einschätzungen wählt das System eine Handlung – von der Parameteranpassung bis zum automatisch erzeugten Arbeitsauftrag.
Der entscheidende Unterschied liegt im Ursprung des Verhaltens. Eine SPS tut, was ein Ingenieur explizit programmiert hat. Ein KI-Modell hingegen lernt sein Verhalten aus Beispielen. Dadurch toleriert KI Automation Streuung und neue Muster, die in der Realität ständig auftreten – wechselnde Materialchargen, Verschleiß oder schwankende Umgebungsbedingungen. Folglich eignet sich der Ansatz überall dort, wo die Wirklichkeit zu komplex ist, um sie vollständig in Regeln zu fassen.
Klassische Automatisierung vs. KI Automation
Beide Ansätze verfolgen dasselbe Ziel: Prozesse ohne ständiges manuelles Eingreifen ablaufen zu lassen. Sie unterscheiden sich jedoch grundlegend in ihrer Funktionsweise. Die folgende Tabelle stellt die wichtigsten Merkmale gegenüber.
| Kriterium | Klassische Automatisierung | KI Automation |
|---|---|---|
| Grundlage | Feste Regeln und Logik (SPS, SCADA) | Aus Daten gelernte Modelle |
| Verhalten | Deterministisch, exakt wiederholbar | Adaptiv, wahrscheinlichkeitsbasiert |
| Umgang mit Varianz | Gering – jede Ausnahme braucht eine neue Regel | Hoch – toleriert Streuung und neue Muster |
| Wahrnehmung | Diskrete Signale und Grenzwerte | Bilder, Geräusche, komplexe Muster |
| Anpassung | Manuelle Umprogrammierung | Nachtraining mit neuen Daten |
| Nachvollziehbarkeit | Vollständig transparent | Erklärbarkeit variiert je nach Modell |
Wichtig ist dabei ein Punkt, den die Tabelle nicht ausdrücken kann: KI Automation ersetzt die deterministische Steuerung nicht, sondern ergänzt sie. Sicherheitskritische Regelkreise – ein Not-Aus, eine Drehzahlregelung, eine Verriegelung – bleiben bei der klassischen, vollständig nachvollziehbaren Logik. KI übernimmt die Aufgaben darüber: Wahrnehmung, Prognose und Optimierung. In der Praxis arbeiten beide Ebenen deshalb zusammen. Die SPS garantiert den sicheren Grundbetrieb, während das KI-Modell die Entscheidungen liefert, die feste Regeln nicht abbilden können.
Aufgaben auf dem Shopfloor mit KI automatisieren
Der Weg von der Idee zur produktiven KI Automation folgt einem wiederkehrenden Muster. Zunächst erfasst das System Daten aus dem Prozess. Anschließend interpretiert ein Modell diese Daten. Schließlich löst das Ergebnis eine Handlung aus – im einfachsten Fall einen Hinweis, im Vollausbau einen automatischen Eingriff. Auf dem Shopfloor lässt sich dieses Prinzip auf sehr unterschiedliche Aufgaben anwenden.
Konkrete Anwendungsfälle
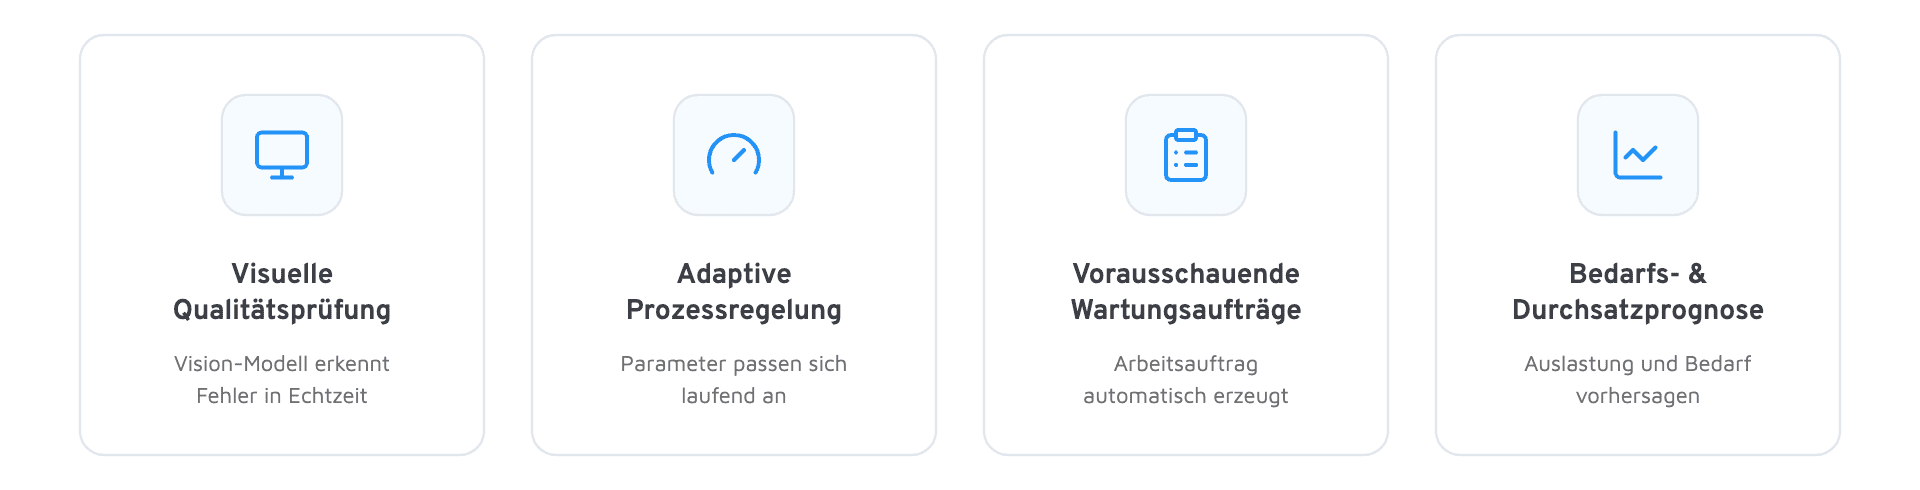
- Visuelle Qualitätsprüfung: Ein Vision-Modell inspiziert Bauteile in Echtzeit und erkennt Kratzer, Risse oder fehlende Komponenten – Fehler, die sich über keine feste Regel beschreiben lassen. Das System sortiert fehlerhafte Teile automatisch aus.
- Adaptive Prozessregelung: Statt starrer Sollwerte passt ein Modell Parameter wie Temperatur, Druck oder Vorschub laufend an Materialcharge und Werkzeugverschleiß an und hält so die Qualität stabil.
- Vorausschauende Wartungsaufträge: Erkennt ein Modell ein Verschleißmuster, erzeugt die KI Automation automatisch einen Arbeitsauftrag im Instandhaltungssystem – inklusive Fehlerbild und empfohlenem Termin.
- Autonome Agenten: KI-Agenten überwachen Live-Daten kontinuierlich und handeln eigenständig innerhalb definierter Grenzen, etwa indem sie eine Linie umkonfigurieren oder Material nachbestellen.
- Bedarfs- und Durchsatzprognose: Modelle sagen Auslastung, Materialbedarf oder Engpässe voraus und stoßen darauf basierend Planungs- und Nachschubprozesse an.
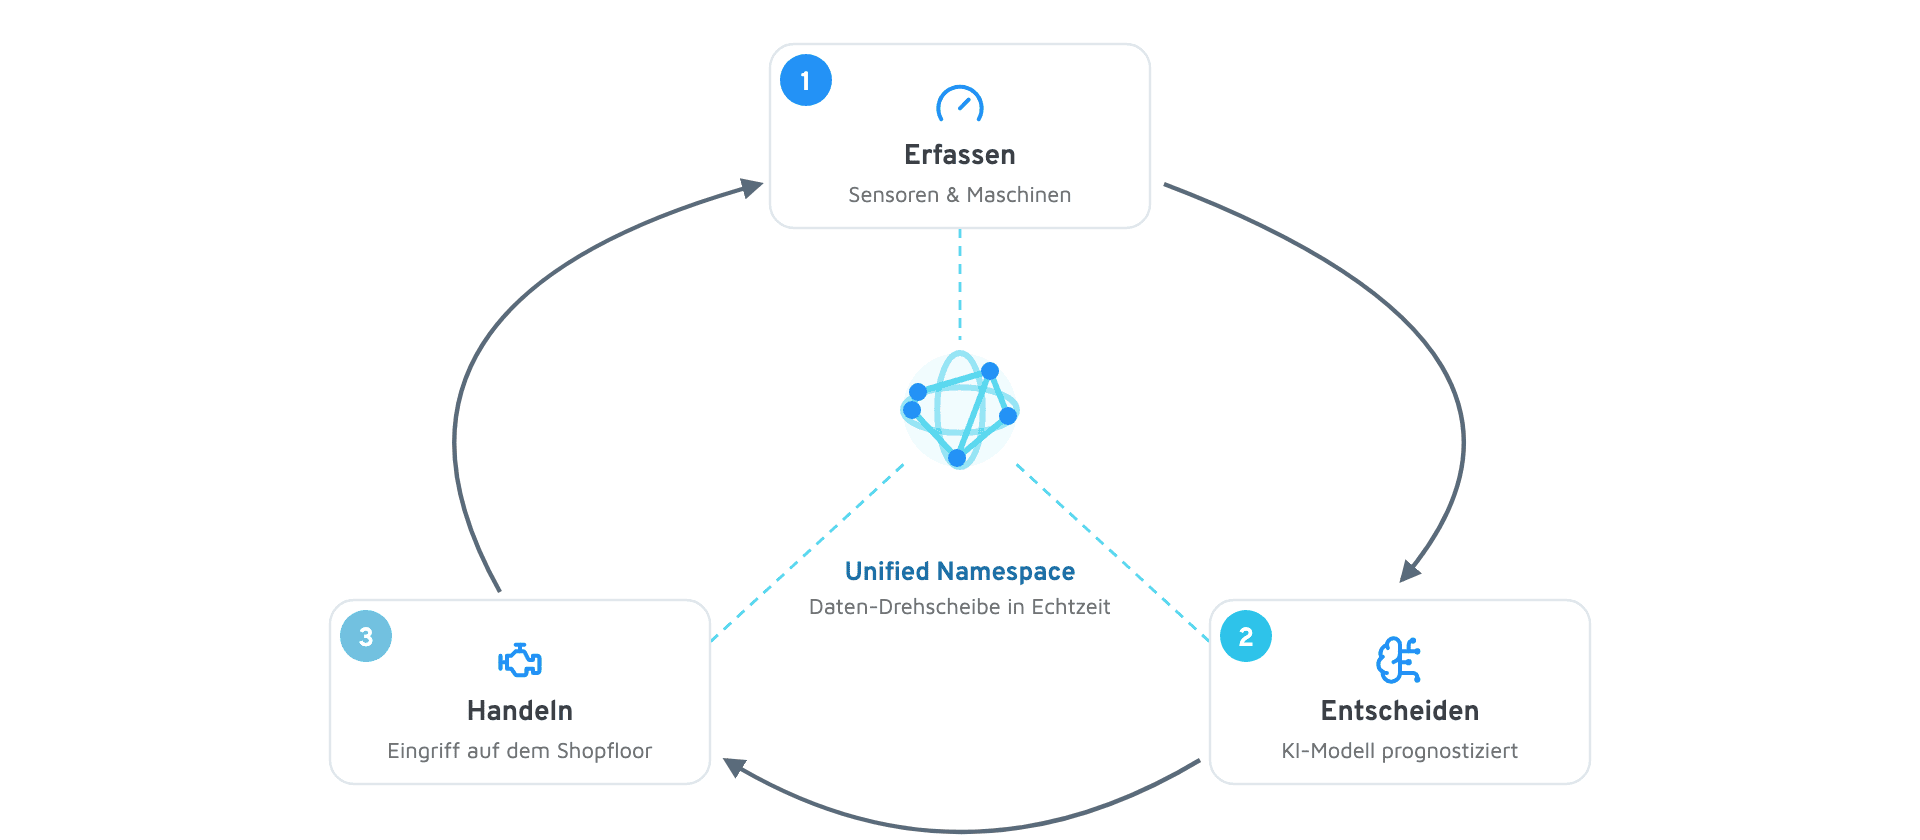
Diese Beispiele unterscheiden sich in Datenquelle und Modell, folgen aber demselben Kreislauf aus Erfassen, Entscheiden und Handeln. Entscheidend ist jedoch, dass jede dieser Anwendungen zuverlässige, kontextualisierte Daten voraussetzt. Ohne dieses Fundament bleibt selbst das beste Modell wirkungslos.
Das Fundament: Daten und der Unified Namespace
KI Automation ist zuerst ein Datenthema und erst danach ein Modellthema. Ein Modell kann nur entscheiden, was es aus den Daten ablesen kann. Deshalb benötigt jede KI Automation eine einheitliche, kontextualisierte und in Echtzeit verfügbare Datenbasis. In vielen Fabriken liegt genau hier die Hürde: Die Daten existieren, sind aber in isolierten Systemen wie SPS, SCADA oder Historian gefangen und uneinheitlich strukturiert.
Der Unified Namespace (UNS) löst dieses Problem. Er bildet eine zentrale, hierarchisch organisierte Datenschicht, in der alle Systeme über einen gemeinsamen Message Broker – etwa MQTT oder NATS – Daten veröffentlichen und konsumieren. Damit stehen Maschinendaten normalisiert und in Echtzeit als Single Source of Truth (SSOT) bereit. Ein KI-Modell muss sich folglich nicht mit einem Dutzend proprietärer Schnittstellen verbinden, sondern abonniert einfach die relevanten Topics.
Der geschlossene Regelkreis: erfassen, entscheiden, handeln
KI Automation entfaltet ihren Wert erst, wenn eine Entscheidung wieder in den Prozess zurückfließt. Dadurch entsteht ein geschlossener Regelkreis: Sensoren und Maschinen erfassen den Zustand, der UNS stellt die harmonisierten Daten bereit, ein KI-Modell entscheidet, und die Handlung wirkt zurück auf den Shopfloor. Der UNS bildet dabei die Drehscheibe, über die Wahrnehmung und Aktion verbunden sind.
i-flow als Datenfundament für KI Automation
Da KI Automation vor allem ein Datenproblem ist, liegt der Hebel in einer verlässlichen Datenbasis. Die i-flow-Plattform stellt genau dieses Fundament bereit und folgt dabei einem klaren Prinzip: zentrale Konfiguration im i-flow Hub, dezentrale Ausführung über i-flow Edges nah an der Maschine.
Der i-flow Edge verbindet sich direkt mit SPSen, Sensoren und SCADA-Systemen über native Protokolle wie OPC UA, Modbus oder Siemens S7. Er normalisiert die Rohdaten lokal und publiziert sie strukturiert in den UNS. Der i-flow Hub verwaltet Datenmodelle und Verbindungen zentral und rollt Änderungen konsistent auf alle Edges aus. Der i-flow Broker stellt den zentralen Message Broker bereit und sorgt für die zuverlässige Zustellung aller Datenpunkte.
Für KI Automation bedeutet das konkret: Die harmonisierten Daten stehen im UNS bereit, und jedes KI-System kann sie als Consumer abonnieren – ebenso wie eine Handlung über denselben Weg zurück in die Anlage schreiben. Die KI-Entwicklung kann sich damit auf die Modelle konzentrieren, statt auf die Datenbeschaffung.
Best Practices und Grenzen
KI Automation ist kein Selbstläufer. Wie jeder datengetriebene Ansatz entfaltet sie ihren Nutzen nur unter den richtigen Bedingungen. Die folgenden Empfehlungen haben sich in der Praxis bewährt.
Empfehlungen
- Eng beginnen: Starten Sie an einem klar abgegrenzten Anwendungsfall mit messbarem Ziel, statt die gesamte Fabrik auf einmal zu automatisieren.
- Menschen einbinden: Halten Sie den Menschen zunächst in der Schleife. Das Modell schlägt vor, der Mensch entscheidet – erst mit belegter Zuverlässigkeit steigt der Automatisierungsgrad.
- Sicherheit trennen: Überlassen Sie sicherheitskritische Funktionen der deterministischen Steuerung. KI wirkt darüber, nicht darunter.
- Datenqualität sichern: Investieren Sie zuerst in saubere, kontextualisierte Daten. Ein UNS ist hier die tragfähigste Grundlage.
Grenzen
- Abhängigkeit von Daten: Fehlen ausreichende oder repräsentative Daten, bleibt jede Vorhersage unzuverlässig.
- Erklärbarkeit: Nicht jedes Modell lässt sich vollständig nachvollziehen – ein Nachteil in stark regulierten Prozessen.
- Model Drift: Verändern sich Prozesse oder Materialien, verliert ein Modell an Treffsicherheit und muss nachtrainiert werden.
- Wirtschaftlichkeit: Bei einfachen, stabilen Aufgaben kann eine klassische Regel günstiger und robuster sein als KI Automation.
Fazit
KI Automation erweitert die klassische Automatisierung um Wahrnehmung, Vorhersage und lernende Entscheidungen. Sie ersetzt die deterministische Steuerung nicht, sondern setzt darauf auf und übernimmt die Aufgaben, die für feste Regeln zu variabel sind. Ihr Wert entsteht im geschlossenen Regelkreis aus Erfassen, Entscheiden und Handeln – und dieser Kreis schließt sich nur über eine verlässliche Datenbasis. Drei zentrale Erkenntnisse:
- Ergänzung, kein Ersatz: KI Automation arbeitet über der deterministischen Steuerung, die sicherheitskritische Regelkreise weiterhin absichert.
- Daten vor Modellen: Ein einheitliches Datenfundament – idealerweise ein Unified Namespace – ist die Voraussetzung, nicht das Beiwerk.
- Schrittweise statt flächendeckend: Beginnen Sie eng, halten Sie den Menschen in der Schleife und weiten Sie den Ansatz mit wachsender Zuverlässigkeit aus.
Wer heute das Datenfundament legt, schafft die Basis nicht nur für einzelne KI-Anwendungen, sondern für eine durchgängige KI Automation im gesamten Werk.