In der Fertigung fallen täglich enorme Datenmengen an – doch die meisten davon werden nur rückblickend ausgewertet: Reports zeigen, was gestern passiert ist, Dashboards, warum eine Linie stand. Predictive Analytics dreht diesen Blick nach vorn. Statt Vergangenes zu dokumentieren, sagt der Ansatz künftige Ereignisse und Kennwerte aus Betriebsdaten voraus – vom drohenden Maschinenausfall über den Ausschussanteil bis zum Energiebedarf der nächsten Schicht. Als Teil der Industrial-AI-Bewegung verbindet der Ansatz kontinuierliche Datenerfassung, historische Verläufe und maschinelles Lernen. Dieser Artikel erklärt, was Predictive Analytics ist, wie sie sich von Prescriptive Analytics abgrenzt und wie Sie sie schrittweise auf dem Factory Floor umsetzen.
Was ist Predictive Analytics?
Predictive Analytics (deutsch: vorausschauende Analyse) bezeichnet die datengetriebene Vorhersage künftiger Ereignisse oder Kennwerte auf Basis historischer und aktueller Betriebsdaten. Ein Modell lernt aus vergangenen Mustern – etwa dem typischen Verlauf vor einem Lagerschaden – und überträgt dieses Wissen auf die Gegenwart, um eine begründete Prognose zu liefern. Die Kernfrage lautet dabei nicht „Was ist passiert?“, sondern „Was wird voraussichtlich passieren?“.
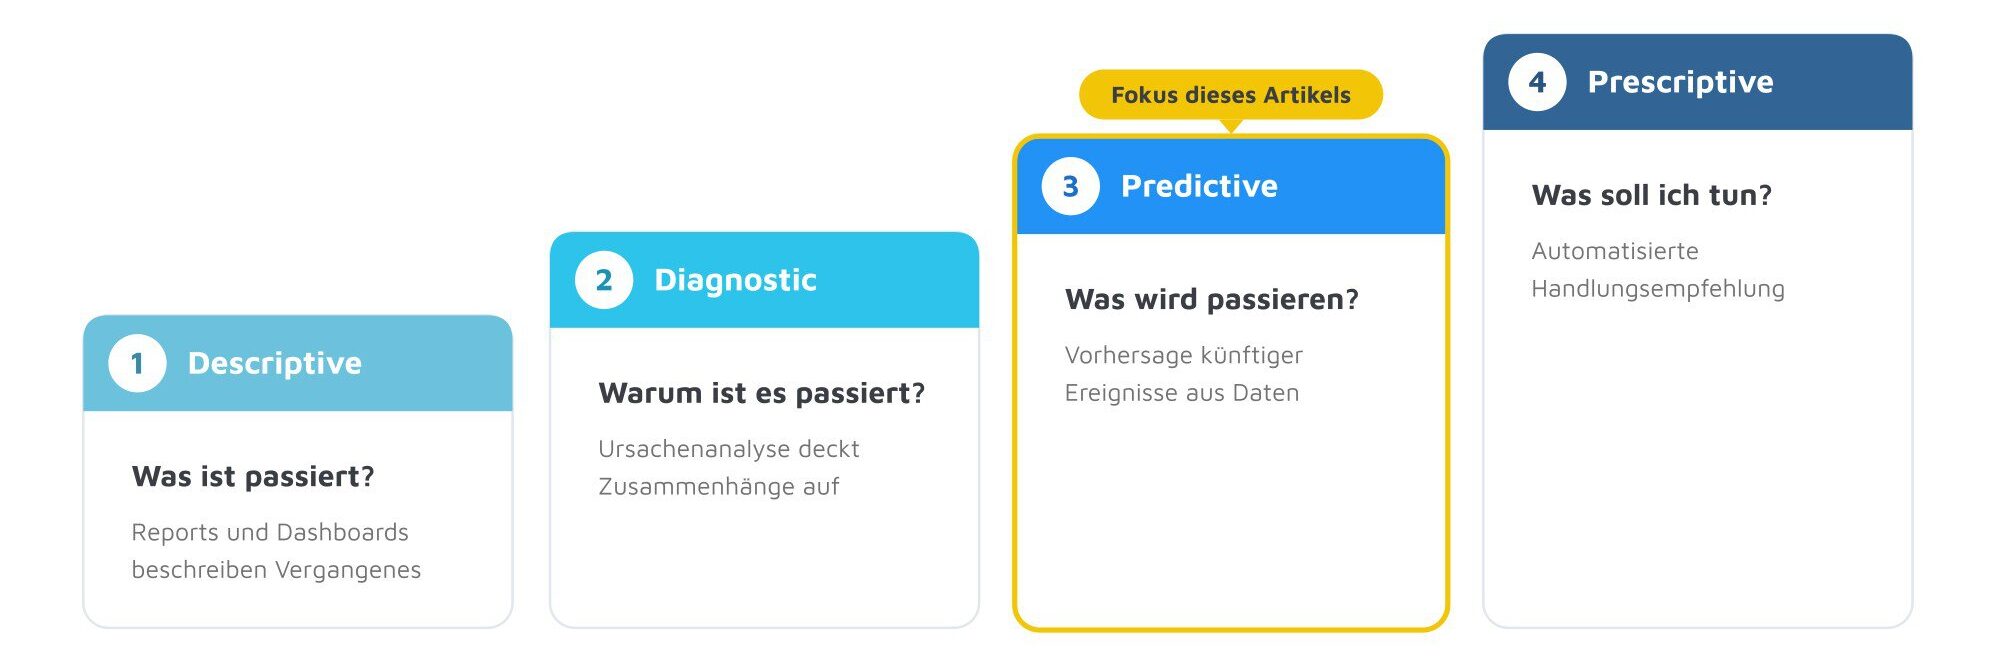
In der Fertigung gibt es dafür zahlreiche konkrete Anwendungsfälle. Sie unterscheiden sich in den Datenquellen und Modellen, folgen aber demselben Grundprinzip:
- Instandhaltung: Vorhersage von Maschinenausfällen aus Vibration, Temperatur oder Stromaufnahme – der bekannteste Anwendungsfall, auch als Predictive Maintenance bezeichnet.
- Qualität: Prognose von Ausschuss oder Nacharbeit aus Prozessparametern, bevor ein fehlerhaftes Teil überhaupt entsteht.
- Kapazität und Nachfrage: Vorhersage von Durchsatz, Auslastung oder Materialbedarf zur besseren Planung von Schichten und Beständen.
- Energie: Prognose des Energieverbrauchs, um Lastspitzen zu vermeiden und Kosten zu senken.
Das Werkzeug hinter diesen Vorhersagen ist meist maschinelles Lernen. Die Bandbreite reicht von einfacher Regression über Klassifikation bis zu spezialisierten Zeitreihenmodellen. Entscheidend ist jedoch: Ein Modell ist immer nur so gut wie die Daten, mit denen es trainiert und betrieben wird. Damit rückt – wie bei jeder Industrial-AI-Initiative – die Datenerfassung ins Zentrum jeder Predictive-Analytics-Lösung.
Descriptive, Predictive, Prescriptive: die vier Stufen der Analytik
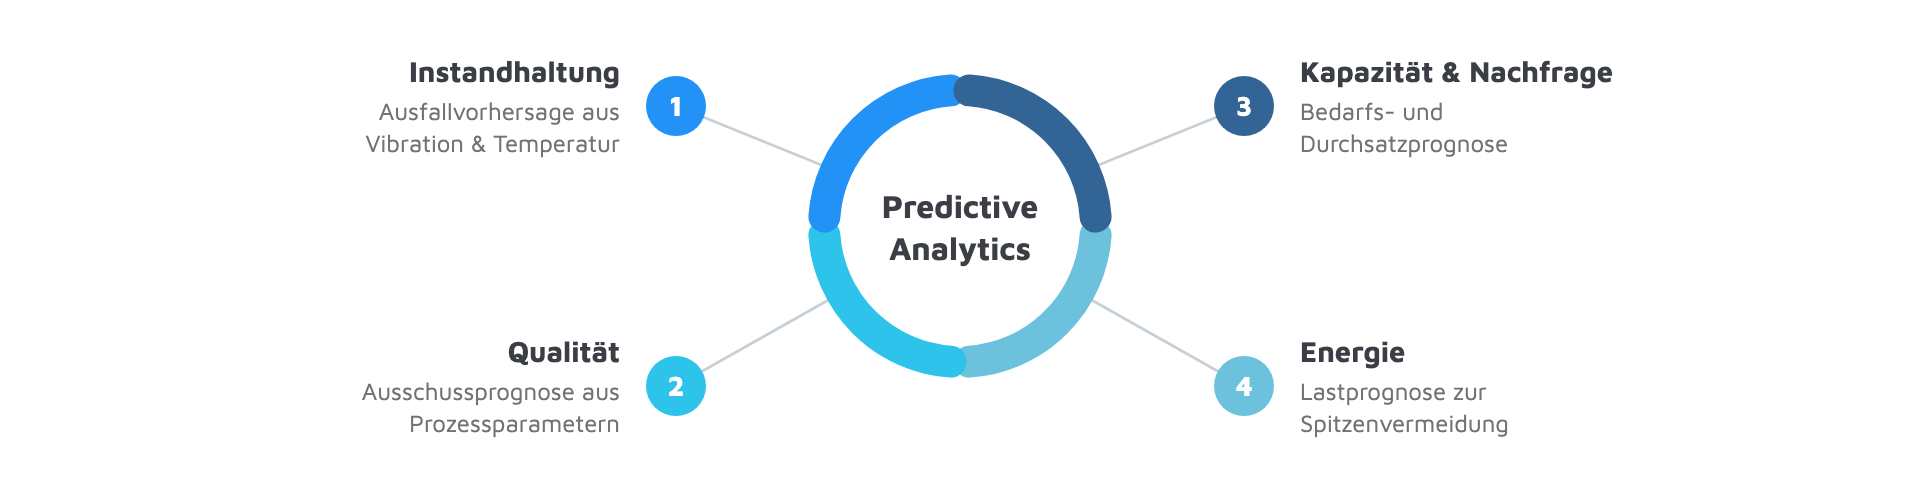
Um Predictive Analytics sauber einzuordnen, hilft das etablierte Modell der vier Analytik-Stufen (siehe Grafik oben). Jede Stufe beantwortet eine andere Frage und liefert einen höheren Wert – erfordert aber auch mehr Daten und Reife:
- Descriptive Analytics – „Was ist passiert?“ Rückblickende Auswertung: Reports und Dashboards, die vergangene Zustände beschreiben.
- Diagnostic Analytics – „Warum ist es passiert?“ Ursachenanalyse, die Zusammenhänge und Auslöser hinter einem Ereignis aufdeckt.
- Predictive Analytics – „Was wird passieren?“ Vorhersage künftiger Ereignisse und Kennwerte aus historischen Mustern.
- Prescriptive Analytics – „Was soll ich tun?“ Ableitung konkreter, oft automatisierter Handlungsempfehlungen aus der Vorhersage.
Der Unterschied zwischen Predictive und Prescriptive Analytics
Beide Stufen blicken in die Zukunft, verfolgen aber unterschiedliche Ziele. Predictive Analytics prognostiziert – sie liefert eine Wahrscheinlichkeit oder einen Wert, überlässt die Entscheidung aber dem Menschen. Prescriptive Analytics geht einen Schritt weiter und empfiehlt auf Basis dieser Prognose eine konkrete Handlung, häufig durch Optimierungsverfahren gestützt und teilweise automatisiert.
Ein Beispiel aus der Fertigung macht den Unterschied greifbar. An einem Antriebsmotor durchläuft ein Lagerschaden alle vier Stufen: Descriptive Analytics meldet, dass die Lagertemperatur gestern erhöht war. Diagnostic Analytics erkennt, dass die Erhöhung mit steigender Vibration korreliert. Predictive Analytics prognostiziert, dass das Lager in rund 12 Betriebstagen ausfällt. Prescriptive Analytics empfiehlt schließlich, den Tausch für kommenden Donnerstag einzuplanen, weil dann ohnehin ein Stillstand ansteht und das Ersatzteil verfügbar ist. In der Praxis ist eine belastbare Vorhersage fast immer die Voraussetzung für sinnvolle Handlungsempfehlungen – deshalb ist die vorausschauende Analyse der entscheidende Baustein auf dem Weg zur Prescriptive-Stufe.
Voraussetzung: Daten als Fundament
Predictive Analytics steht und fällt mit der Datenqualität. Ein Vorhersagemodell benötigt kontinuierliche, saubere und kontextualisierte Betriebsdaten – über Wochen und Monate hinweg, aus unterschiedlichen Quellen und in konsistentem Format. Genau hier liegt in vielen Fabriken die eigentliche Hürde: Die Daten existieren zwar, sind aber in isolierten Systemen (SPS, SCADA, Historian) gefangen und uneinheitlich strukturiert.
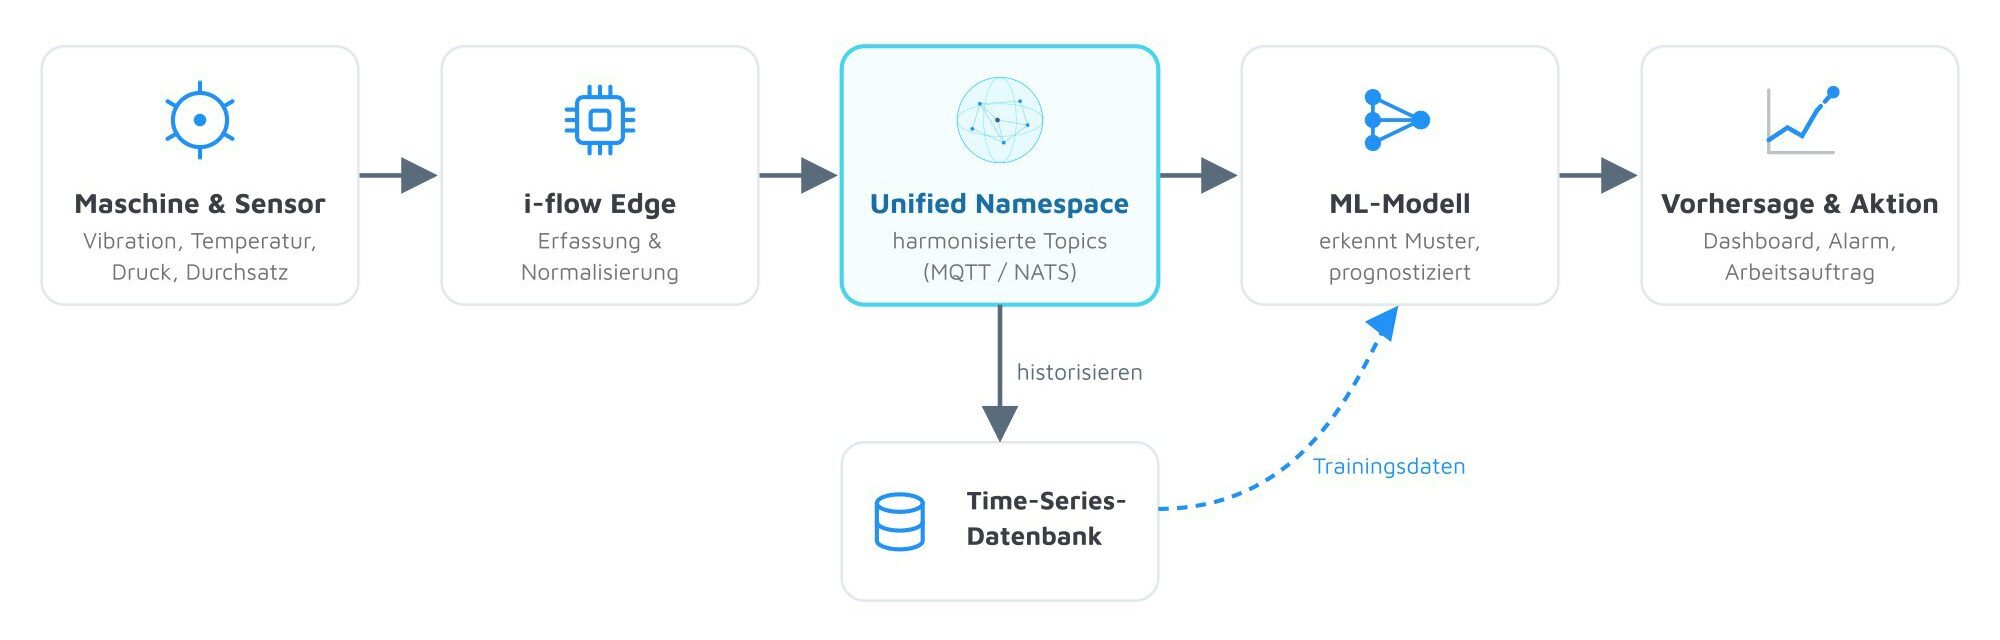
Der Unified Namespace (UNS) adressiert dieses Problem. Er bildet eine zentrale, hierarchisch organisierte Datenschicht, in der alle Systeme Daten über einen gemeinsamen Message Broker – etwa MQTT oder NATS – veröffentlichen und konsumieren. Damit stehen Maschinendaten normalisiert und in Echtzeit als Single Source of Truth (SSOT) bereit. Für Predictive Analytics bedeutet das: Ein Modell muss sich nicht mit einem Dutzend proprietärer Schnittstellen verbinden, sondern abonniert einfach die relevanten Topics im UNS.
Ebenso wichtig ist die Historisierung. Modelle werden auf historischen Daten trainiert, insbesondere auf Zeiträumen rund um vergangene Ereignisse wie Ausfälle oder Qualitätsabweichungen. Eine Time-Series-Datenbank speichert diese Verläufe langfristig und liefert die Trainingsgrundlage. Der UNS und die Historisierung bilden somit das Fundament, auf dem jede vorausschauende Analyse aufsetzt.
Predictive Analytics implementieren
Der Einstieg gelingt am besten schrittweise – nicht als flächendeckendes Großprojekt über die gesamte Fabrik, sondern an einem klar abgegrenzten Anwendungsfall. Die folgenden fünf Schritte bilden einen bewährten Weg, um Predictive Analytics produktionsreif aufzubauen.
- Vorhersagefrage und Zielkennzahl definieren: Beginnen Sie mit einer konkreten Frage statt mit der Technik. Was genau soll vorhergesagt werden – ein Lagerausfall, der Ausschussanteil einer Charge, der Energiebedarf? Legen Sie fest, welche Kennzahl die Vorhersage verbessern soll und woran Sie den Erfolg messen.
- Relevante Datenquellen anbinden: Verbinden Sie die Signale, die den vorherzusagenden Zustand ankündigen. Viele liefern bestehende Steuerungen bereits über native Protokolle wie
OPC UA,ModbusoderSiemens S7. Wo Größen wie Vibration fehlen, ergänzen zusätzliche Sensoren die Datenbasis. - Daten normalisieren und in den UNS publizieren: Vereinheitlichen Sie Einheiten, Zeitstempel und Namenskonventionen und publizieren Sie die Daten in eine konsistente Topic-Struktur nach ISA-95, zum Beispiel
werk01/assembly/line01/motor01/vibration. Diese Harmonisierung ist die Voraussetzung dafür, dass ein Modell die Daten überhaupt verlässlich nutzen kann. - Historisieren und einfachstes Modell wählen: Schreiben Sie die UNS-Daten in eine Time-Series-Datenbank und beginnen Sie mit dem einfachsten tragfähigen Modell. Häufig genügt zunächst eine Regel- oder Anomalieerkennung; komplexe Prognosemodelle folgen erst, wenn genügend historische Daten vorliegen.
- Vorhersagen operationalisieren: Eine Prognose entfaltet erst Wirkung, wenn sie in einen Prozess zurückfließt – als Alarm im Leitstand, als Kennzahl im Dashboard oder als automatisch erzeugter Arbeitsauftrag. Wo es sich lohnt, ist dies der Übergang zur Prescriptive-Stufe: aus der Vorhersage wird eine konkrete Handlungsempfehlung.
Wichtig ist der iterative Charakter: Ein erstes Modell wird selten perfekt sein. Sammeln Sie Betriebserfahrung, verfeinern Sie die Modelle und weiten Sie den Ansatz erst dann auf weitere Anwendungsfälle aus. Achten Sie dabei auf „Model Drift“ – verändern sich Prozesse, Materialien oder Maschinen, verliert ein Modell an Treffsicherheit und muss nachtrainiert werden.
Nutzen und Grenzen von Predictive Analytics
Die vorausschauende Analyse ist kein Selbstzweck und kein Allheilmittel. Wie jeder datengetriebene Ansatz bringt sie klare Vorteile, aber auch reale Grenzen mit sich. Eine ehrliche Abwägung ist die Voraussetzung für eine wirtschaftlich sinnvolle Einführung.
Vorteile
- Vom Reagieren zum Vorausplanen: Ereignisse werden erkannt, bevor sie eintreten – das schafft Zeit für geplantes Handeln statt teurer Ad-hoc-Reaktionen.
- Bessere Planbarkeit: Wartung, Personal, Material und Energie lassen sich auf Basis belastbarer Prognosen vorausschauend disponieren.
- Datenbasierte Entscheidungen: Entscheidungen stützen sich auf objektive Muster in den Betriebsdaten statt auf Erfahrungswerte oder Bauchgefühl.
- Fundament für Prescriptive Analytics: Zuverlässige Vorhersagen sind die Voraussetzung für automatisierte Handlungsempfehlungen in der nächsten Ausbaustufe.
Grenzen
- Hoher initialer Aufwand: Datenerfassung, UNS-Anbindung und Historisierung müssen zuerst aufgebaut werden. Ohne dieses Fundament bleibt jede Vorhersage unzuverlässig.
- Abhängigkeit von historischen Daten: Modelle brauchen ausreichend Beispiele aus der Vergangenheit. Fehlen diese – etwa bei neuen Anlagen –, ist Anomalieerkennung der pragmatischere Startpunkt.
- Laufende Modellpflege: Modelle müssen überwacht und regelmäßig nachtrainiert werden, sonst sinkt ihre Treffsicherheit durch Model Drift.
- Nicht überall wirtschaftlich: Bei unkritischen Prozessen kann der Aufwand den Nutzen übersteigen – eine einfache Auswertung reicht dann aus.
Die Konsequenz aus dieser Abwägung: Der Ansatz lohnt sich dort am meisten, wo Ereignisse teuer sind, sich in den Daten ankündigen und ausreichend Historie vorliegt. Der gezielte Einstieg an solchen Anwendungsfällen ist deshalb wirtschaftlich sinnvoller als eine flächendeckende Einführung.
i-flow als Datenfundament für Predictive Analytics
Da vorausschauende Analyse zuerst ein Datenproblem ist, liegt der Hebel in einer verlässlichen Datenbasis. Die i-flow-Plattform stellt genau dieses Fundament bereit und folgt dabei einem klaren Prinzip: zentrale Konfiguration im i-flow Hub, dezentrale Ausführung über i-flow Edges nah an der Maschine.
Der i-flow Edge verbindet sich direkt mit SPSen, Sensoren und SCADA-Systemen über native Protokolle wie OPC UA, Modbus oder Siemens S7. Er normalisiert die Rohdaten lokal – nah an der Quelle, mit minimaler Latenz – und publiziert sie strukturiert in den UNS. Der i-flow Hub verwaltet Datenmodelle und Verbindungen zentral und rollt Änderungen konsistent auf alle Edges aus. Der i-flow Broker stellt den zentralen Message Broker bereit und sorgt für die zuverlässige Zustellung aller Datenpunkte.
Für Predictive Analytics heißt das konkret: Die harmonisierten Daten stehen im UNS bereit, und jedes Analyse- oder KI-System kann sie als Consumer abonnieren – ohne sich um Protokolldetails oder proprietäre Schnittstellen zu kümmern. Die Datenanalyse kann sich damit auf die Modelle konzentrieren, statt auf die Datenbeschaffung.
Fazit
Predictive Analytics verlagert den Blick in der Fertigung vom Rückblick zur Vorhersage. Sie erkennt künftige Ereignisse aus realen Betriebsdaten und schafft damit den Handlungsspielraum, der descriptive und diagnostic Auswertungen fehlt. Von der Prescriptive-Stufe unterscheidet sie sich klar: Predictive Analytics prognostiziert, Prescriptive Analytics empfiehlt die Handlung – und baut dabei auf der Prognose auf.
Entscheidend ist jedoch die richtige Reihenfolge. Predictive Analytics ist kein reines KI-Thema, sondern zuerst ein Datenthema. Ohne kontinuierliche, harmonisierte und historisierte Daten bleibt selbst das beste Modell wirkungslos. Drei zentrale Erkenntnisse:
- Daten vor Modellen: Ein tragfähiges Datenfundament – idealerweise ein Unified Namespace – ist die Voraussetzung, nicht das Beiwerk.
- Schrittweise statt flächendeckend: Beginnen Sie an einem klar abgegrenzten Anwendungsfall, sammeln Sie Erfahrung und weiten Sie den Ansatz danach aus.
- Vorhersage vor Handlung: Predictive Analytics ist die Grundlage, auf der Prescriptive Analytics und automatisierte Entscheidungen erst möglich werden.
Wer heute das Datenfundament legt, schafft die Basis nicht nur für Predictive Analytics, sondern für weitere Industrial-AI-Anwendungen im gesamten Werk.